OS_Lab5_updated
内核线程
实验概述
本次实验会学习C语言的可变参数机制的实现方法,然后实现一个简单的printf函数,通过printf()和gdb来帮助debug;同时会实现内核线程(定义PCB;实现基于时钟中断的RR算法)。
实验要求
- DDL:2024.5.4 24:00
- 提交的内容:将3+1(选做)个assignment的代码和实验报告放到压缩包中,命名为“lab5-学号-姓名”,并交到课程邮箱 os_sysu_lab@163.com
- 将实验报告的pdf提交至 http://inbox.weiyun.com/3CiJFwEn
- 材料的Example的代码放置在
src目录下。
参考资料
printf的实现
printf()可以使用任意数量的参数来调用,这类函数称为可变参数函数
C语言的可变参数机制
C语言允许我们使用定义可变参数函数,此时函数参数列表分为两部分:固定参数(如int,char* )+可变参数(用 ...来表示)
例如:
1 | int printf(const char* const _Format, ...); |
- 可变参数函数,参数列表中至少要有一个固定参数
- 可变参数列表必须放在形参列表最后
为了引用可变参数列表中的参数,我们需要用到 <stdarg.h>头文件定义的一个变量类型 va_list和三个宏 va_start,va_arg,va_end,这三个宏用于获取可变参数列表中的参数,用法如下。
| 宏 | 用法说明 |
|---|---|
va_list |
定义一个指向可变参数列表的指针。 |
void va_start(va_list ap, last_arg) |
初始化可变参数列表指针 ap,使其指向可变参数列表的起始位置,即函数的固定参数列表的最后一个参数 last_arg的后面第一个参数。(使用固定参数的最后一个参数来初始化可变参数指针) |
type va_arg(va_list ap, type) |
以类型 type返回可变参数,并使 ap指向下一个参数。 |
void va_end(va_list ap) |
清零 ap。 |
- 可变参数必须从头到尾逐个访问。如果你在访问了几个可变参数之后想半途中止,这是可以的,但是,如果你想一开始就访问参数列表中间的参数,那是不行的(可以把想访问的中间参数之前的参数读取但是不使用,曲线救国)。
- 这些宏是无法直接判断实际实际存在参数的数量。
- 这些宏无法判断每个参数的类型,所以在使用
va_arg的时候一定要指定正确的类型。 - 如果在
va_arg中指定了错误的类型,那么将会影响到后面的参数的读取。 - 第一个参数也未必要是可变参数个数,例如
printf的第一个参数就是字符串指针。
无论参数数量有多少,这些参数都被统一地按函数调用给出的顺序放到了栈上,只不过使用可变参数的函数并不知道这些栈上的参数具体含义=>才需要使用 va_arg来指定参数的类型
$可变参数列表的起始地址=固定参数列表的最后一个参数的地址+这个参数的大小$
初始化了 parameter后,我们就使用 parameter和 va_arg来引用可变参数。
从本质上来说,parameter就是指向函数调用栈的一个指针,类似 esp、ebp,va_arg按照指定的类型来返回 parameter指向的内容。注意,在 va_arg返回后,parameter会指向下一个参数,无需我们手动调整。
src:2
定义的几个宏
1 | #define _INTSIZEOF(n) ((sizeof(n) + sizeof(int) - 1) & ~(sizeof(int) - 1)) |
作用:_INTSIZEOF 宏:对齐宏,将给定类型的大小向上舍入为sizeof(int)的倍数。(push和pop是32位的,所以都像4字节对齐)
sizeof(n) + sizeof(int) - 1确保我们有足够的字节& ~(sizeof(int) - 1)通过屏蔽掉低位来确保适当的对齐
va_start 宏:初始化va_list使其指向第一个可变参数
&v是最后一个命名参数的地址_INTSIZEOF(v)计算需要跳过多少字节才能到达第一个可变参数- 结果指针指向可变参数列表的开头
va_arg 宏:获取下一个参数
- 它将指针前进适当对齐的请求类型大小:
ap += _INTSIZEOF(type) - 然后再回调相同的大小:
- _INTSIZEOF(type) - 将结果地址转换为请求类型的指针:
(type *) - 解引用该指针以获取值:
*(type *)
va_end宏:将va_list指针设置为NULL来清理,标记可变参数的结束
Example1 实现printf
- 定义:
int printf(const char *const fmt,...);- 首先找到fmt中形如
%c,%d,%x,%s对应的参数,然后用这些参数具体的值来替换,得到新的格式化输出字符串(fmt的解析) - 最后printf将这个新的格式化输出字符即可。
- 首先找到fmt中形如
[!NOTE]
实际上,我们会定义一个缓冲区,然后对fmt进行逐字符地解析,将结果逐字符的放到缓冲区中。放入一个字符后,我们会检查缓冲区,如果缓冲区已满,则将其输出,然后清空缓冲区,否则不做处理。
- 我们还需要实现:
- 一个能输出字符串的函数
- 这个函数要能正确处理换行(光标移动到下一行开始)
- 光标超过了屏幕表示范围需要滚屏
1 | int STDIO::print(const char *const str) |
| 符号 | 含义 |
|---|---|
| %d | 按十进制整数输出 |
| %c | 输出一个字符 |
| %s | 输出一个字符串 |
| %x | 按16进制输出 |
| printf() |
1 | int printf(const char *const fmt, ...) |
添加到缓冲区函数
1 | int printf_add_to_buffer(char *buffer, char c, int &idx, const int BUF_LEN) |
内核线程
- 程序、进程、线程
用户线程和内核线程
- 用户线程:线程只由用户进程实现,os察觉不到(无线程机制)=>一旦挂起,整个进程挂起
- 内核线程:让进程更多地占用CPU资源,某一线程阻塞了也只会阻塞这个线程,不会影响其他线程
线程的描述
- 五个状态(创建态、运行态、就绪态、阻塞态、终止态)
1 | enum ProgramStatus |
- PCB数据结构
1 | struct PCB |
- stack:各个线程虽然共享内核空间,但是又有自己的栈,这个栈保存在PCB中;
- 每个PCB会被分配一个页,上面的数据结构PCB只是这个页的低地址部分,栈指针从这个页的结束为止向下递减。(所以栈的空间是有限的,过多会覆盖PCB的信息)
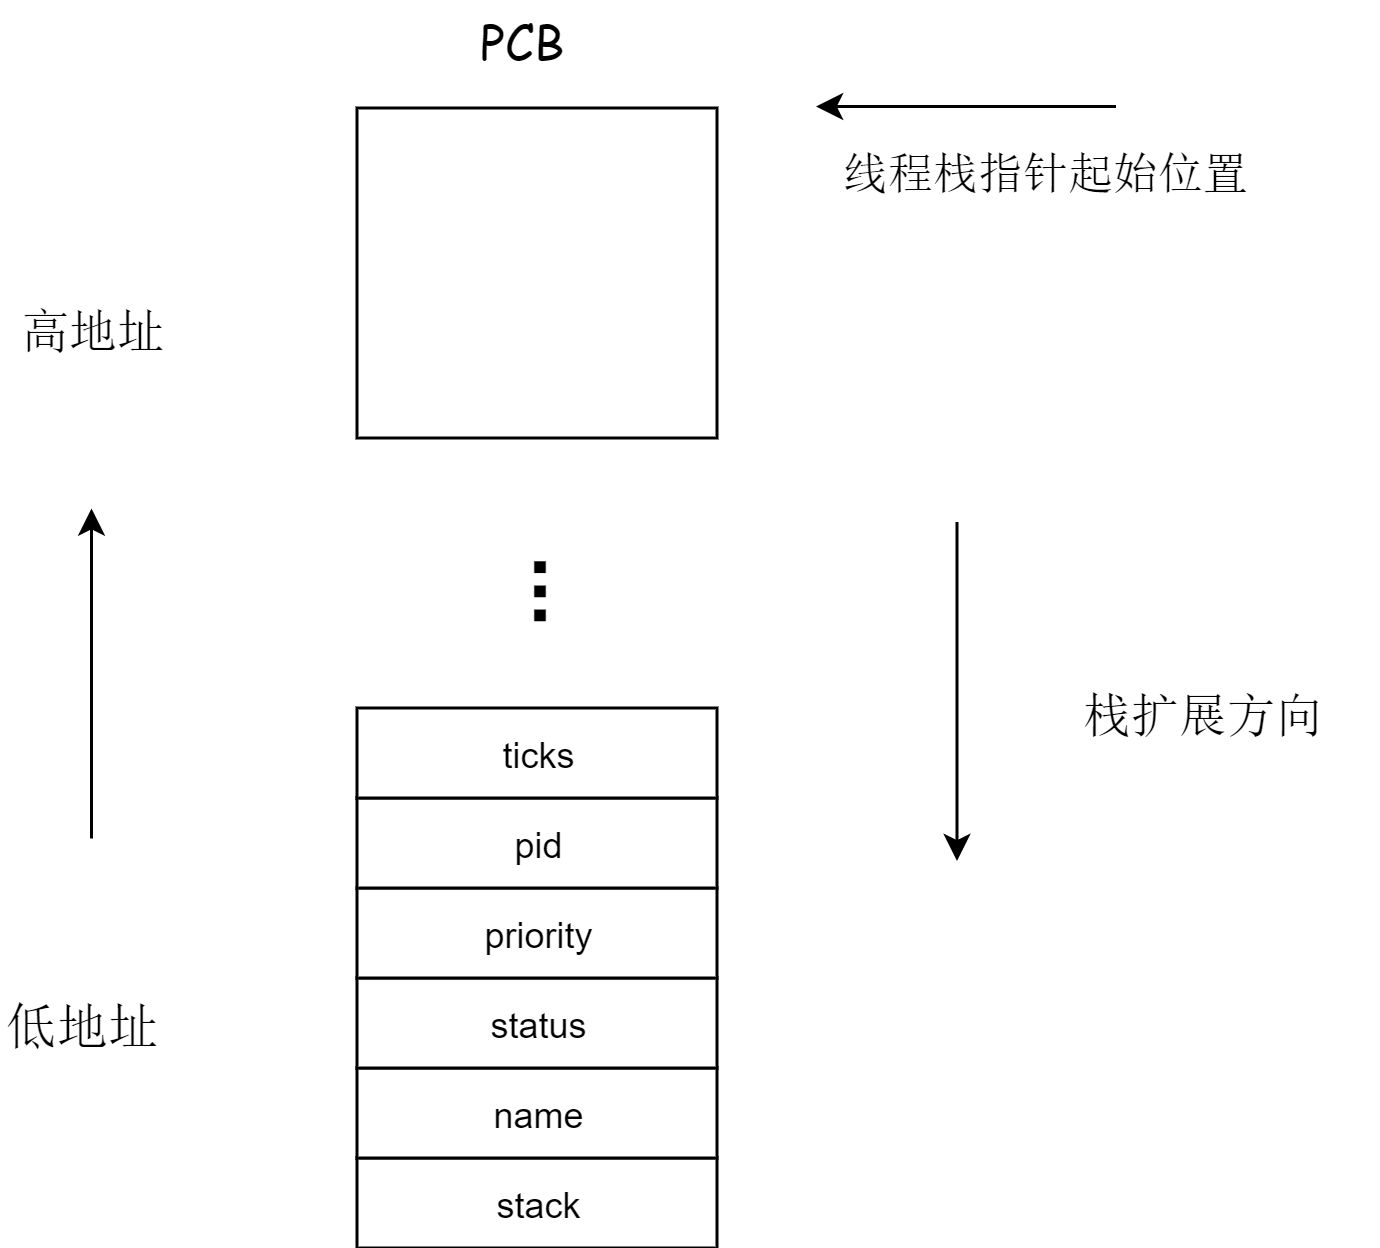
- 每个PCB会被分配一个页,上面的数据结构PCB只是这个页的低地址部分,栈指针从这个页的结束为止向下递减。(所以栈的空间是有限的,过多会覆盖PCB的信息)
ticks是线程剩余的执行次数。在时间片调度算法中,每发生中断一次记为一个tick,当ticks=0时,线程会被换下处理器,然后将其他线程换上处理器执行。ticksPassedBy是线程总共执行的tick的次数。tagInGeneralList和tagInAllList是线程在线程队列中的标识,用于在线程队列中找到线程的PCB。
PCB的分配
- 大小4096个字节(一个页)–目前手动预留–后面实现了内存分页、页内存管理,就是由页内存管理来实现)
1 | // PCB的大小,4KB。 |
- 在
ProgramManager中声明两个管理PCB所在的内存空间函数。
1 | // 分配一个PCB |
allocatePCB会去检查PCB_SET中每一个PCB的状态,如果找到一个未被分配的PCB,则返回这个PCB的起始地址。若未找到,则返回nullptr。- PCB_SET中的PCB是连续存放的,对于第i个PCB,起始地址即为
i*PCB_SIZE releasePCB接受一个PCB指针program,然后计算出program指向的PCB在PCB_SET中的位置,然后将PCB_SET_STATUS中的对应位置设置false即可。
线程的创建
- 加入两个List成员,
allPrograms(所有状态的线程、进程的队列)和readyProframs(处于就绪态的线程、进程的队列) - 创建线程
- 线程实际上执行的是某个函数的代码。(规定线程只能执行返回值为void,参数为
void*的函数
用于创建线程的函数:
- 线程实际上执行的是某个函数的代码。(规定线程只能执行返回值为void,参数为
1 | // 创建一个线程并放入就绪队列 |
具体实现的注解: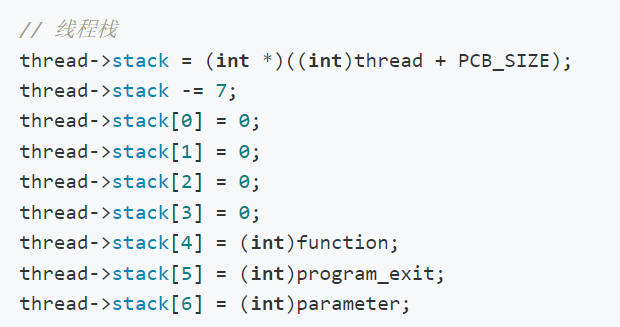
- 4个为0的值是要放到ebp,ebx,edi,esi中的。
thread->stack[4]是线程执行的函数的起始地址。thread->stack[5]是线程的返回地址,所有的线程执行完毕后都会返回到这个地址。thread->stack[6]是线程的参数的地址。
线程调度
在ProgramManager中加入成员running,用来记录当前处理机上执行的线程的PCB
- 本次实验用的方法是RR(时间片轮转算法)
- 线程切换:
- 由于线程的所有信息都在线程栈中,只要我们切换线程栈就能实现线程的切换,线程栈的切换就是将线程的栈指针放到esp中
1 | asm_switch_thread: |
第2-5行,我们保存寄存器ebp,ebx,edi,esi。(C语言规则决定的,要求被调函数主动为主调函数保存这四个寄存器的值)
第7-8行,我们保存esp的值到线程的PCB::statck中,用做下次恢复。注意到PCB::stack在PCB的偏移地址是0。第7行代码是首先将cur->stack的地址放到eax中,第8行向[eax]中写入esp的值,也就是向cur->stack中写入esp。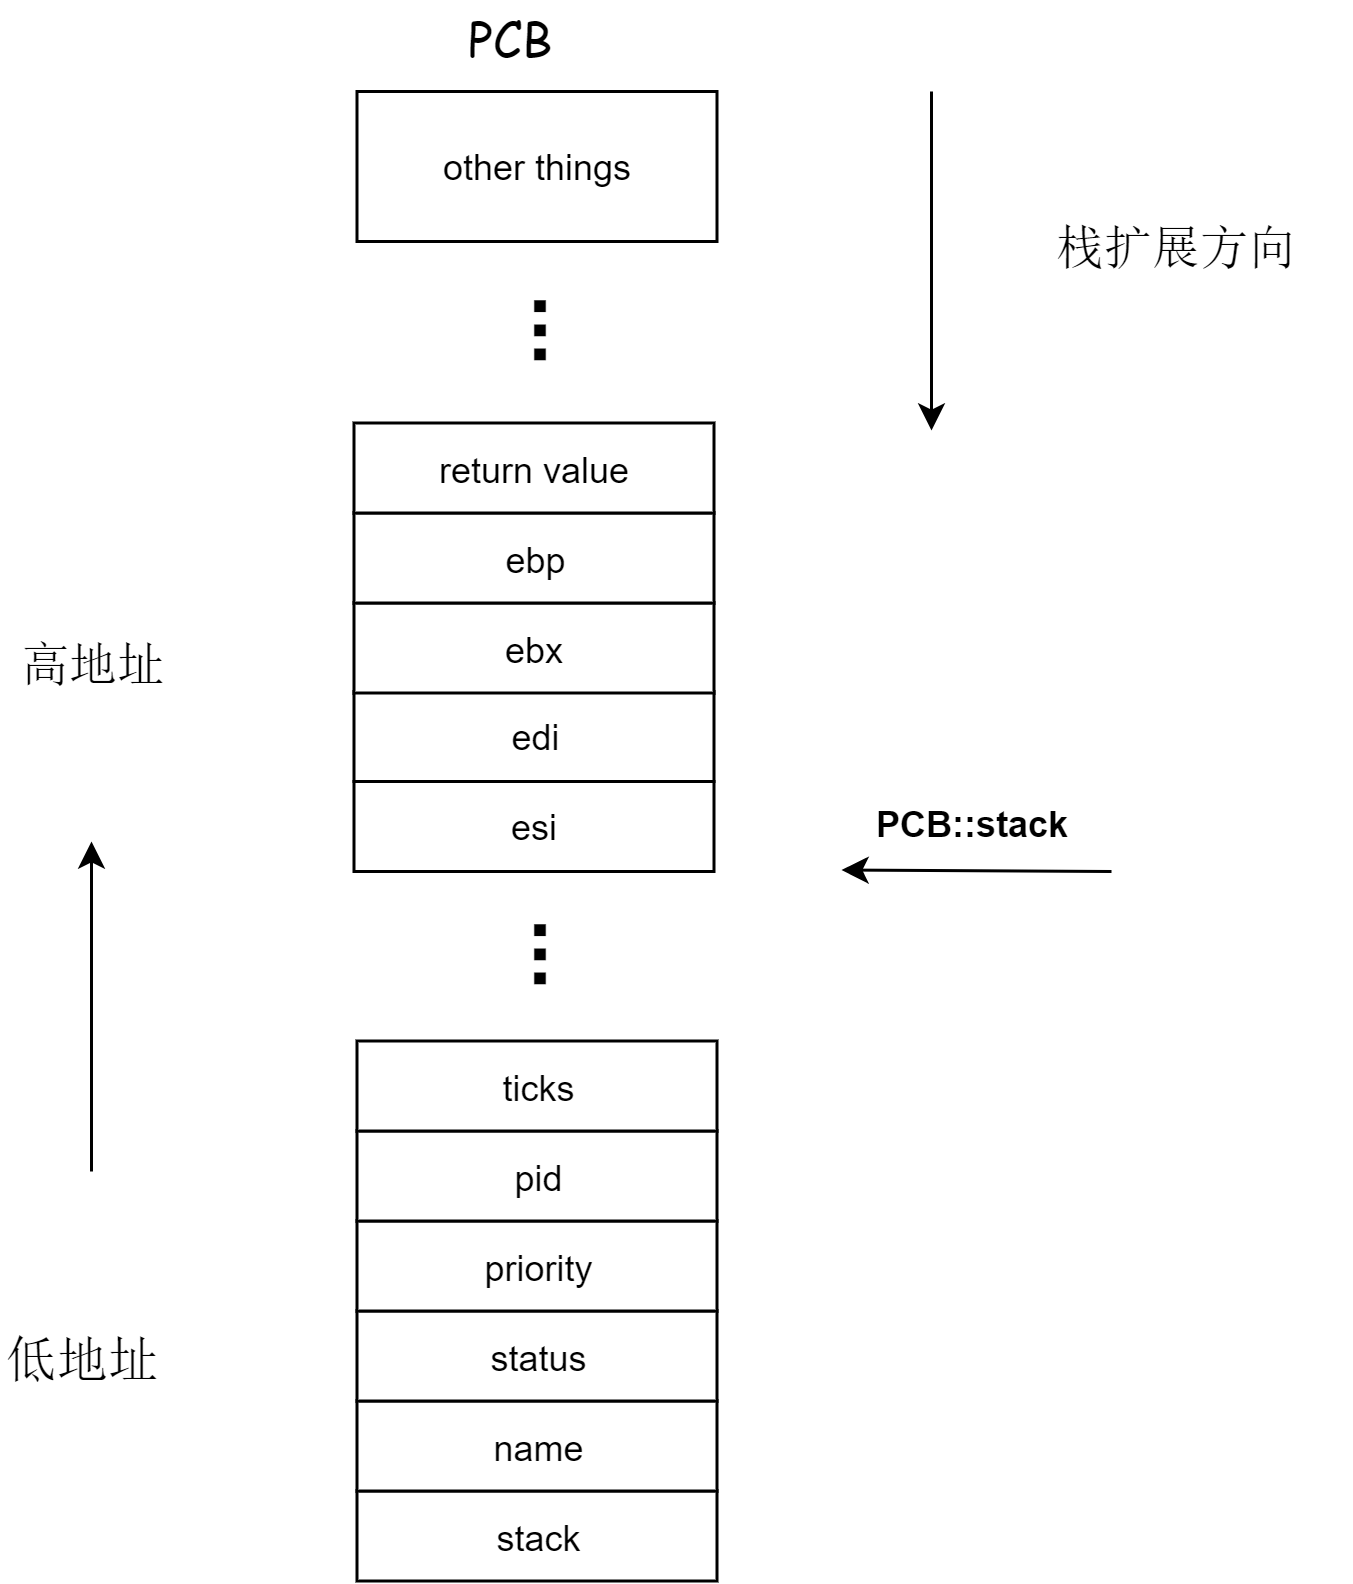
第10-11行,我们将next->stack的值写入到esp中,从而完成线程栈的切换。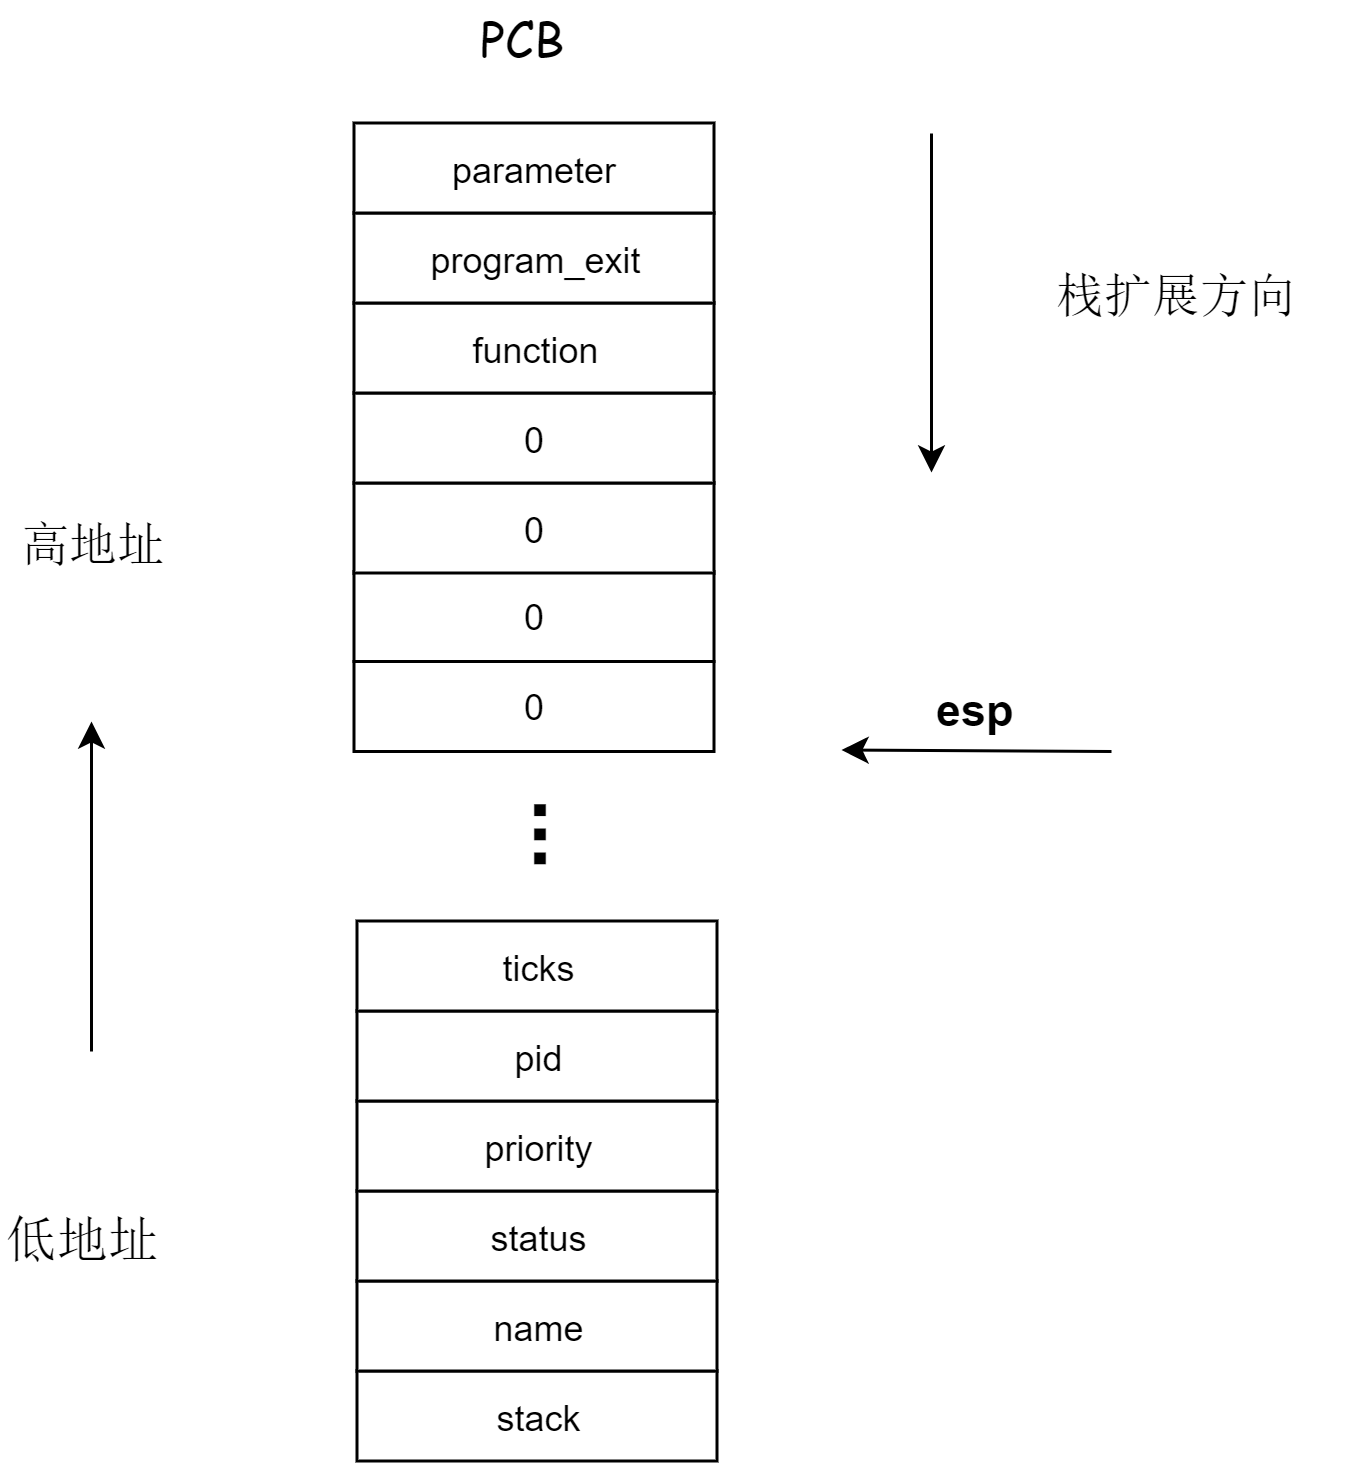
最后使用pop语句将四个0放入寄存器中。
Example2 第一个线程
例子内容:创建第一个线程,并输出”hello world”,pid和线程的名字。
- 第一个线程不可以返回
- 创建第一个线程:由于当前系统中没有线程,因此无法通过在时钟中断调度的方式将第一个线程换上处理器执行。而是要找出第一个线程的PCB,然后手动执行类似
schedule的过程,最后执行asm_switch_thread会强制将第一个线程换上处理器执行。
这一部分是找到第一个线程的PCB,手动设置第一个线程为运行状态
1 | ListItem *item = programManager.readyPrograms.front(); // 获取就绪队列的第一个线程 |
然后再使用线程切换程序,切换到第一个线程。作用是:
- 保存当前的上下文
- 加载第一个线程的上下文
- 跳转到
first_thread执行
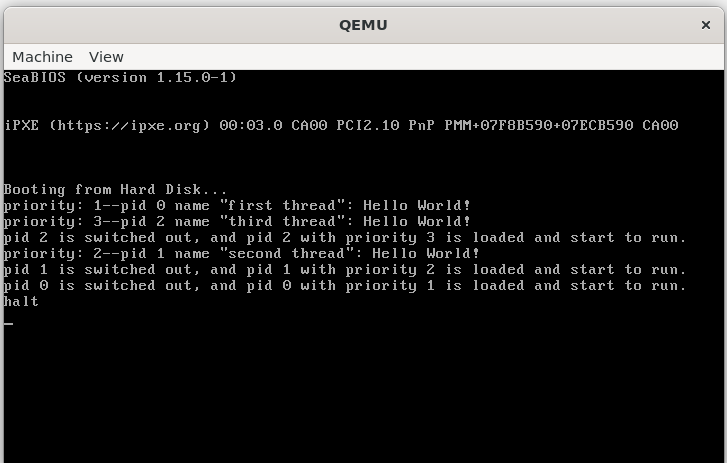
运行结果: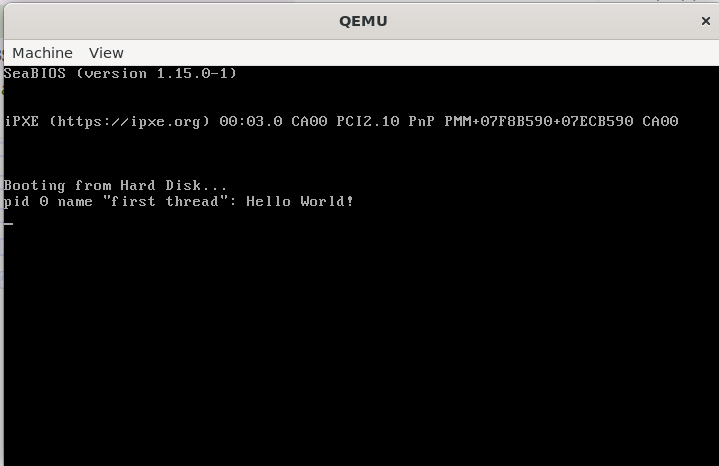
实验任务
Assignment1 printf的实现
学习可变参数机制,然后实现printf,你可以在材料中的printf上进行改进,或者从头开始实现自己的printf函数。结果截图并说说你是怎么做的。
实现过程
- 我决定对材料中的printf进行改进,即添加一些新的格式化输出方式。
- 修改fmt解析过程,添加进新的格式化输出方式
- 得到新的格式化输出字符串之后,将这个字符串打印
PS: - 实际上,我们会定义一个缓冲区,然后对fmt进行逐字符地解析,将结果逐字符的放到缓冲区中。放入一个字符后,我们会检查缓冲区,如果缓冲区已满,则将其输出,然后清空缓冲区,否则不做处理。
材料中定义了一个print函数,作用是正确处理字符串中的换行符,暂时无需修改。
我要做的是修改printf函数实现,加入新的
- 原本有的:
%d,%c,%s,%x,%% - 加入:
%f,%o,(还可能加入左右对齐)
再次观察一下原本的printf函数实现
1 | const int BUF_LEN = 32; // 缓冲区大小(32字节) |
初始化可变参数:
1 | va_start(ap, fmt); // 初始化 ap,使其指向第一个可变参数 |
遍历格式化字符串 fmt 直至遇到 \0
- 一些判断
普通字符:存入buffer
这里的printf_add_to_buffer函数用于:
- 将字符
fmt[i]写入buffer[idx] - 如果
buffer满了,先调用stdio.print(buffer)刷新缓冲区 - 返回
1(表示成功写入一个字符)
1 | if (fmt[i] != '%') |
格式化占位符:检查下一个字符,决定如何处理
- 如果%是最后一个字符,直接结束
- 根据几种不同情况来进行处理
输出%的情况:
%%的情况:将%加入到buffer中
1 | case '%': |
[!NOTE]
C语言中当函数使用可变参数时,某些类型的参数会自动提升为更大的类型,以确保参数的传递一致性
| 原始类型 | 提升后的类型 |
|---|---|
char |
int |
short |
int |
float |
double |
- %c的情况:从可变参数列表取出一个字符
所以这里从可变参数列表中提取的是一个int(即使我们传入的是char)
1 | case 'c': |
- %s的情况:先刷新buffer,然后直接用stdio.print输出参数字符串,避免拷贝到buffer
1 | case 's': |
- %d和%x的情况:
先从参数列表中取出一个整数,然后进行处理
如果是一个负数,需要手动处理(%d)
然后将整数转换为字符串,逆序写入
1 | case 'd': |
加入%f和%o:
实现方法:
八进制添加方法比较简单,直接参照十进制和十六进制即可
1 | case 'd': |
浮点数输出稍微麻烦一点:
1 | case 'f': //浮点数 |
其他的部分和输出整数类似,但是需要重新写ftos函数,用于将浮点数转换为字符串
1 | void ftos(char *buf, double value, int precision = 6) { |
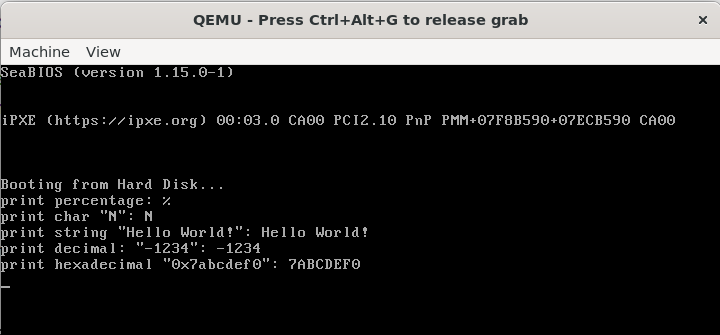
打印结果: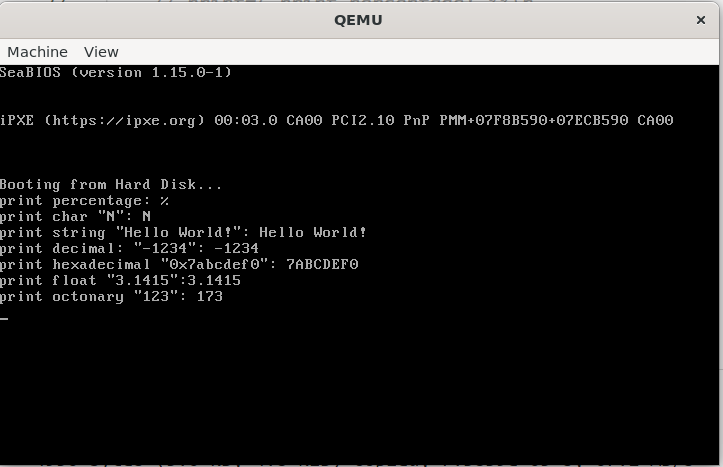
Assignment 2 线程的实现
自行设计PCB,可以添加更多的属性,如优先级等,然后根据你的PCB来实现线程,演示执行结果。
实现过程:
我为PCB添加了优先级属性,修改了代码中的线程程序,打印出了优先级。但是由于我们还没有实现按照优先级进行抢占等调度方式,只实现了RR,所以并不会发生优先级抢占。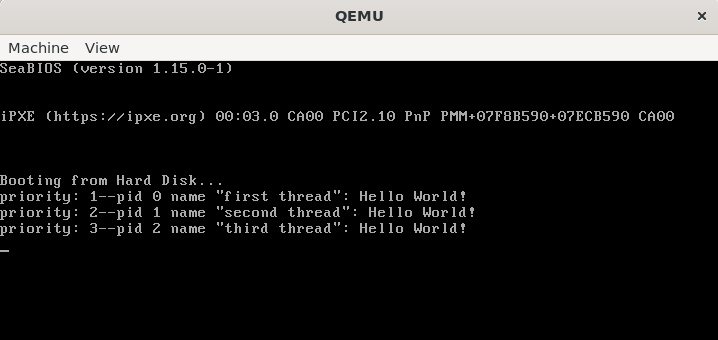
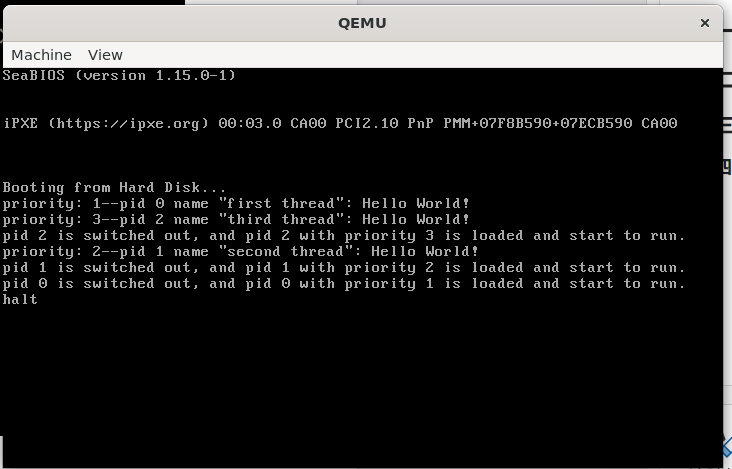
Assignment 3 线程调度切换的秘密
操作系统的线程能够并发执行的秘密在于我们需要中断线程的执行,保存当前线程的状态,然后调度下一个线程上处理机,最后使被调度上处理机的线程从之前被中断点处恢复执行。现在,同学们可以亲手揭开这个秘密。
编写若干个线程函数,使用gdb跟踪c_time_interrupt_handler、asm_switch_thread等函数,观察线程切换前后栈、寄存器、PC等变化,结合gdb、材料中“线程的调度”的内容来跟踪并说明下面两个过程。
- 一个新创建的线程是如何被调度然后开始执行的。
- 一个正在执行的线程是如何被中断然后被换下处理器的,以及换上处理机后又是如何从被中断点开始执行的。
通过上面这个练习,同学们应该能够进一步理解操作系统是如何实现线程的并发执行的。
实现方法:
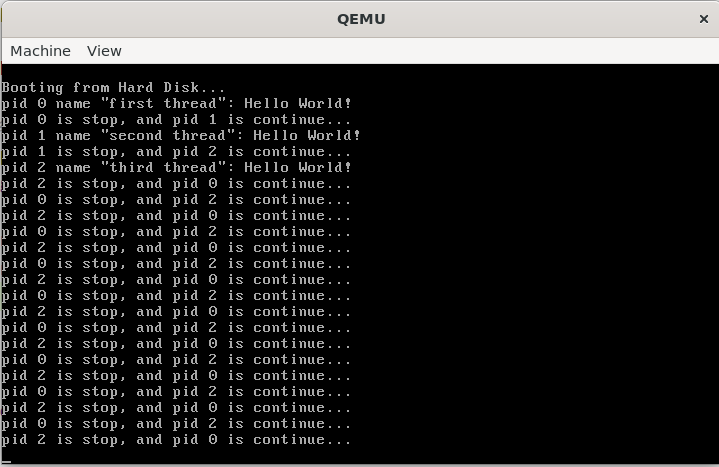
首先我在调度函数( schedule())中加入了打印信息:
开启gdb模式:
先追踪setup_kernel()函数
- 先修改一下gdbinit添加断点
1 | target remote:1234 |
再打开gdb
1 | make debug |
启动界面如图所示: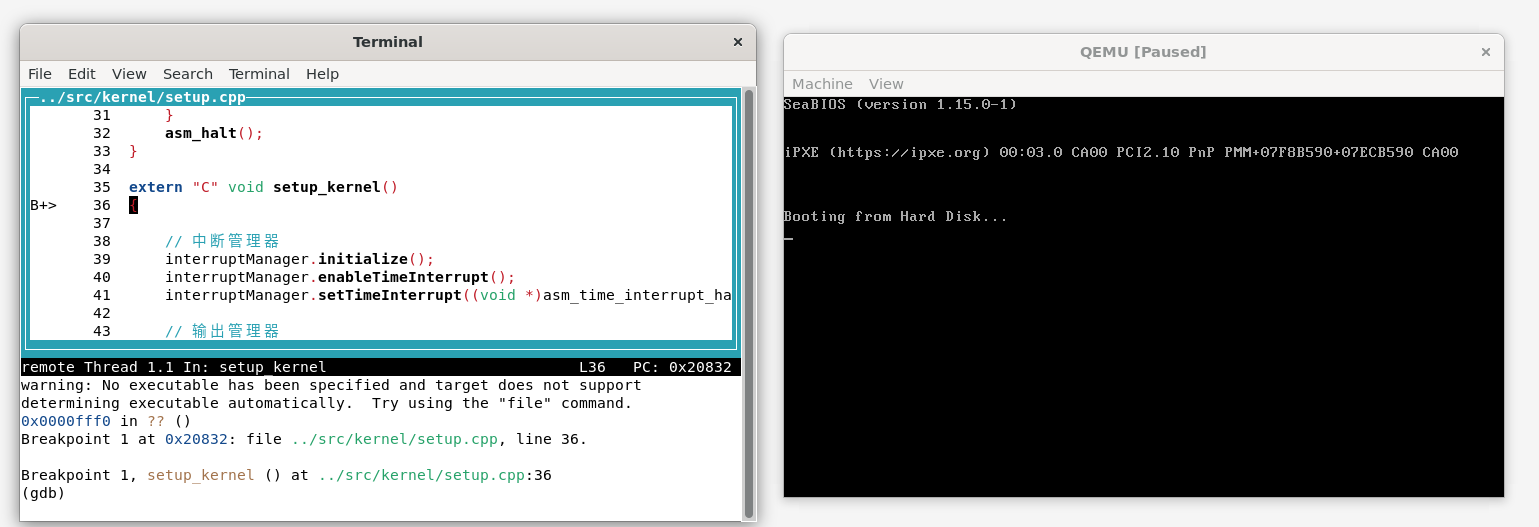
已经加载好符号表,并跳转到即将进入setup_kernel()
一直到切换线程之前都没有输出,因为并没有调用调度函数。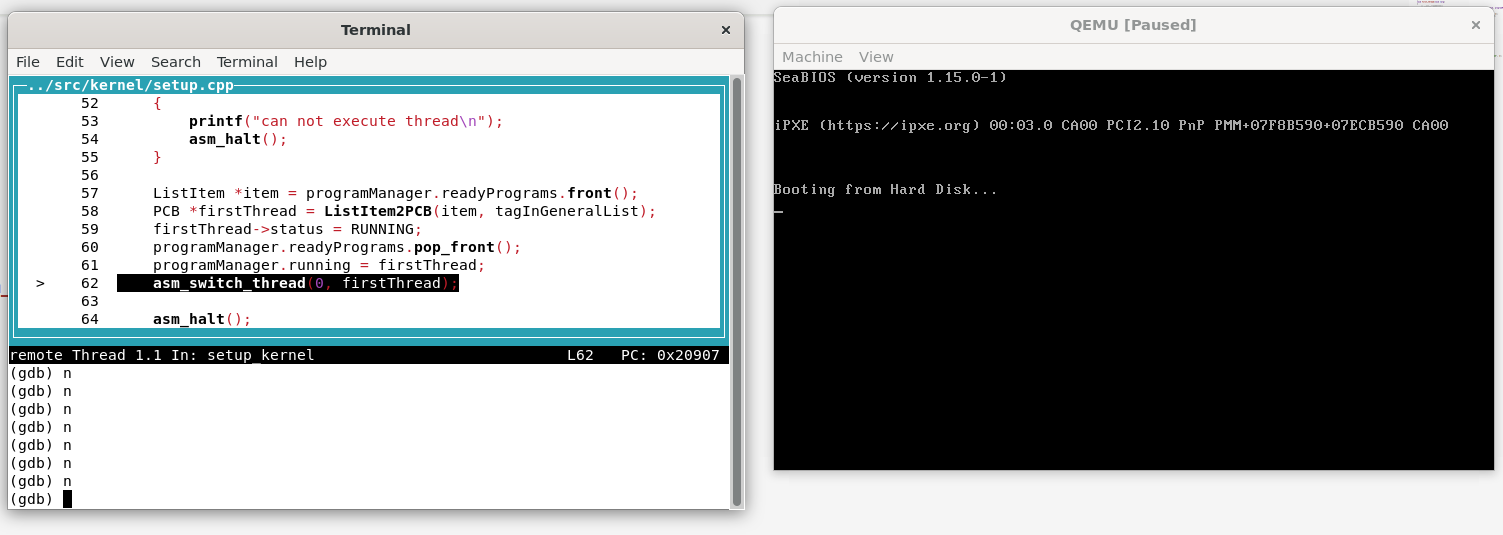
但再向前一步就有输出了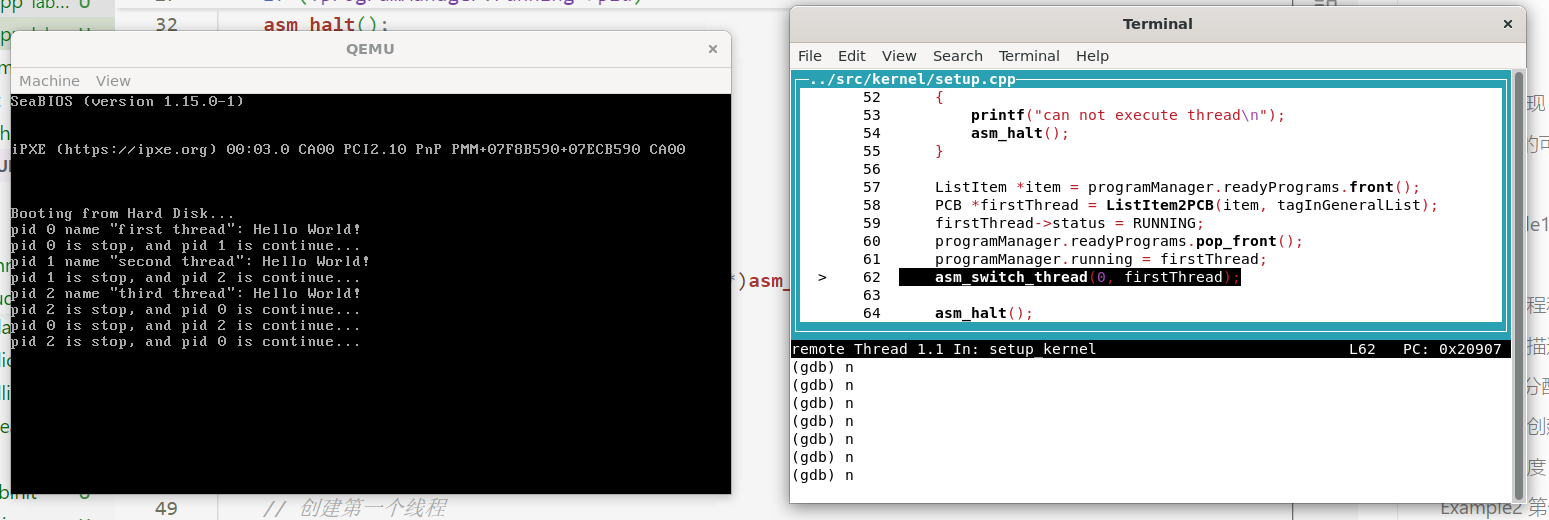
现在发现pid=0的进程无法退出(根),而third_thread程序中是死循环,所以会一直在pid=0和pid=2之间一直切换
再跟踪c_time_interrupt_handler()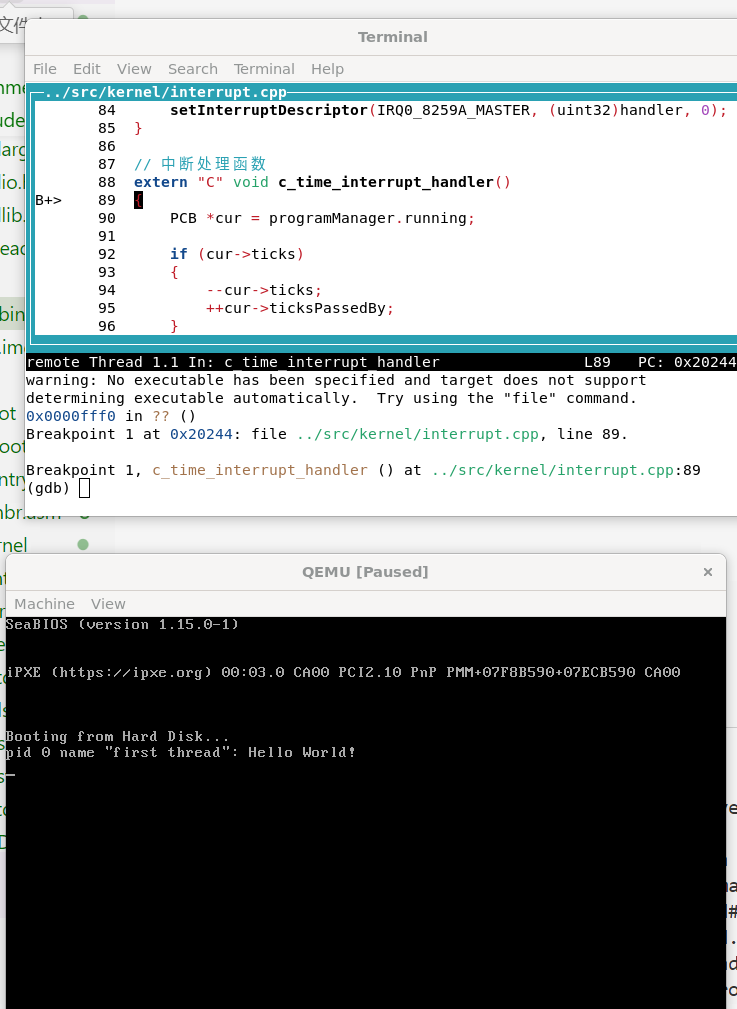
可以看到启动后屏幕上打印了线程1的执行情况,说明现在进入了中断
在schedule()函数中我们设置了时间片为优先级*10,在创建线程时我们设置优先级均为1,所以时间片就为10了。所以要十次才会轮换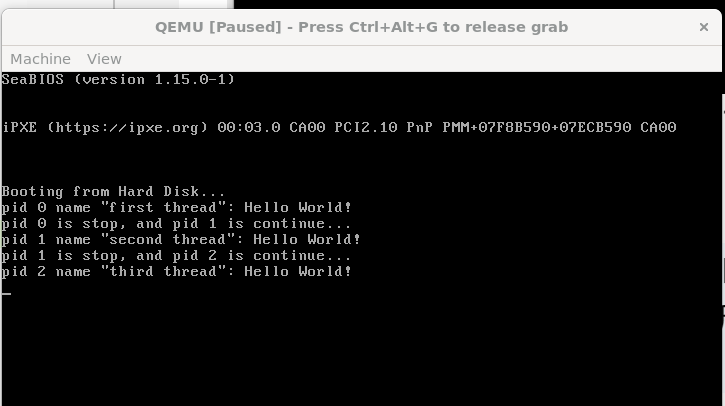
又过10次: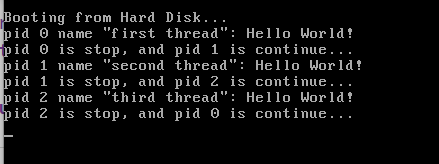
又过10次: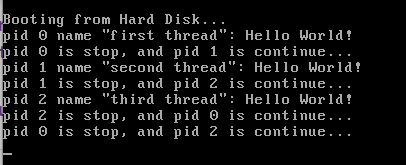
ps: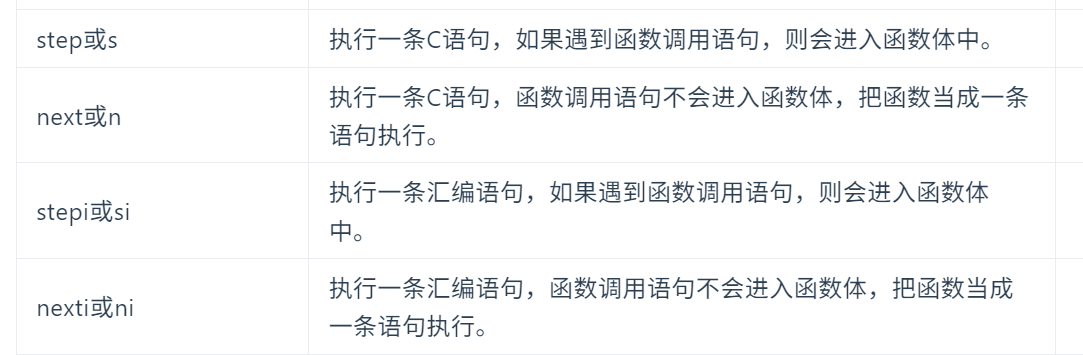
总的来说:
- 线程并发执行的核心原理是通过快速、时分复用地切换CPU的使用权,给用户造成一种“所有线程同时运行的错觉”
- 新线程被选中是因为next指针指向了新创建线程的PCB
- 进入 asm_switch_thread 时,cur指向当前运行的线程,next指向新创建的线程,同时保存了cur线程的上下文。单步执行或者continue之后,PC会跳转到新线程的入口函数的第一条指令,然后开始执行。
- 中断的发生、切换与恢复
- 触发中断后会进入到
c_time_interrupt_handler中 - 其中会处理tick计数、判断时间片是否用完等
- 触发中断后会进入到
- 线程切换会使用到asm_switch_thread函数,最后ret恢复执行,再次调度回去。
(必做与选做)Assignment 4 调度算法的实现
在材料中,我们已经学习了如何使用时间片轮转算法来实现线程调度。但线程调度算法不止一种,例如
- 先来先服务。
- 最短作业(进程)优先。
- 响应比最高者优先算法。
- 优先级调度算法。
- 多级反馈队列调度算法。
此外,我们的调度算法还可以是抢占式的。
现在,同学们需要将线程调度算法修改为上面提到的算法或者是同学们自己设计的算法。然后,同学们需要自行编写测试样例来呈现你的算法实现的正确性和基本逻辑。最后,将结果截图并说说你是怎么做的。(先来先服务为必做,其他为选做)
参考资料:https://zhuanlan.zhihu.com/p/97071815
Tips:
- 先来先服务最简单。
- 有些调度算法的实现可能需要用到中断。
提示:你可能需要改动的地方:
1 | lab5/src/4/include/program.h |
1 | lab5/src/4/src/kernel/program.cpp |
1 | lab5/src/4/src/kernel/setup.cpp |
FIFO算法:
按照任务进入队列的顺序,依次调用,执行完一个任务再执行下一个任务,只有当任务结束后才会发生切换。
SJF算法:
按照任务的耗时长短进行调度,优先调度耗时短的任务,这个算法有个前提,需要预先知道每个任务的耗时情况,这在实际情况中是不大现实的。另外,这个时间是指任务剩余还需要的执行时间,举例,一个耗时1小时的任务还剩10秒执行完成,这个时候若再来一个耗时1分钟的任务,调度仍然还是继续执行完那个耗时1小时的任务,因为他剩余的时间是10秒,比1分钟短,所以此算法又叫最短剩余时间任务有限算法(SRTJ),能够解决FIFO算法中短耗时任务等待前面耗时长任务的窘境。
先实现先进先出算法:
由于是执行完一个任务就执行下一个任务,即在任务结束才发生切换,不需要使用中断函数。
1 | void ProgramManager::FIFO_schedule() |
1 | void third_thread(void *arg) { |
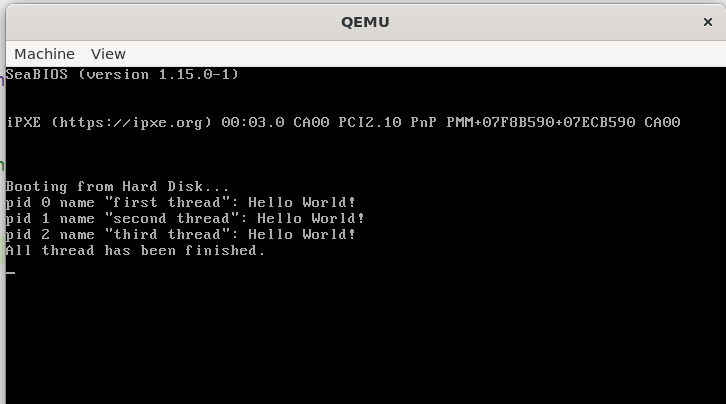
(非抢占)优先级调度算法:
主要就是每次执行完一个线程之后,运行下一个线程是从队列中取出优先级最高的线程来执行。
代码:
1 | void ProgramManager::priority_schedule() |
修改一下线程,让输出可以显示出优先级的作用
1 | void third_thread(void *arg) { |
实现结果: